
Hacía tiempo que no escribía por aquí.
De hecho, Leanalytics ha pasado a llamarse www.experimentaciononline.com y ocupa ese nombre como dominio dentro de Substack. Al final entendí que el juego de palabras de Lean Analytics era un tanto confuso y quizás “Experimentación Online” es algo más sencillo (y, por qué no decirlo, hace honor a mi libro Experimentación Online).
Pero hay un cambio más importante. Durante este 2026 lancé mi propio sitio web donde escribiré en inglés, un idioma con el que me siento cómodo escribiendo y que creo que empezará poco a poco a ser mi lengua primaria en contexto de datos, experimentación, producto e IA generativa.
Sin embargo, creo que dejar de escribir para 1.200 suscritos sería un error, al igual que lo sería cambiar el idioma de esta newsletter. Por eso he decidido traducir los futuros artículos que escribiré en www.ubaldohervas.com y otros sitios web al castellano (con la ayuda de IA generativa) y los publicaré aquí para que llegue a más gente.
El artículo original puedes encontrar en Towards Data Science: How I Built a Multi-Agent System for Interrupted Time Series Analysis. Si lo lees en TDS me harás un favor ya que estoy dentro de su programa de autores.
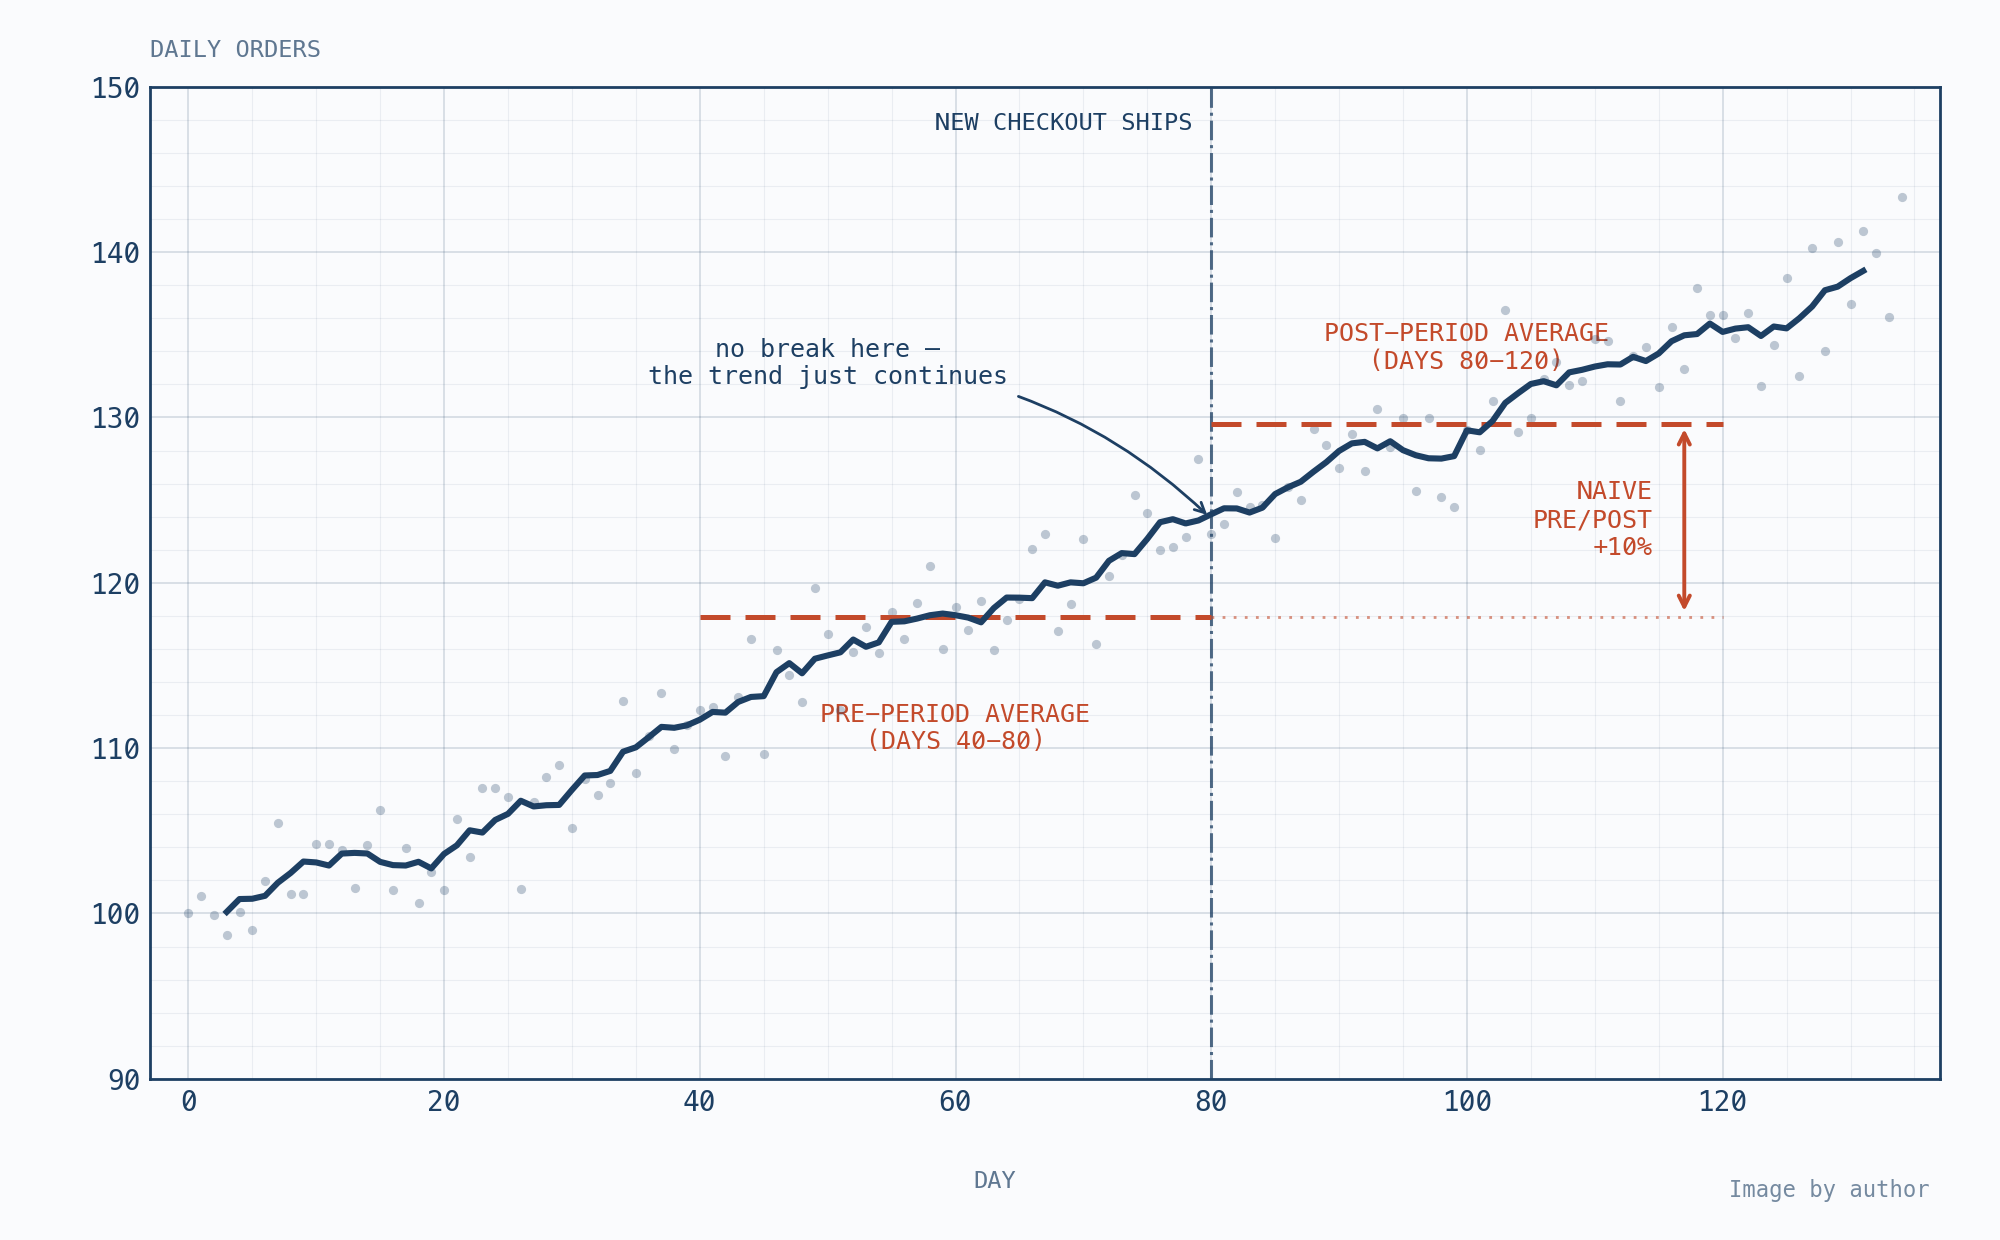
Hace un mes tu empresa decidió lanzar un nuevo proceso de checkout. La hipótesis alternativa era bastante sencilla: un checkout de tres pasos generaría más compras y facturación que el anterior, de un solo paso. Los benchmarks del sector y las buenas prácticas de UX/UI respaldaban la idea.
Para comprobar que esta decisión generaba impacto (y poder cuantificarlo), propusiste ejecutar un test AB. Era la mejor manera de medir el efecto y rechazar la hipótesis nula. El resultado: no conseguiste convencer a los stakeholders de hacer un test AB bien diseñado y el nuevo checkout se lanzó igualmente. Un mes después, esos mismos stakeholders te preguntan: «¿Qué efecto ha tenido el nuevo checkout?», «¿Ha funcionado?» o «¿Hemos perdido dinero con el cambio?».
Estoy bastante seguro de que muchos os habéis encontrado en esta situación. Quizá conozcáis técnicas cuasiexperimentales como Diferencia en diferencias (DiD) o Control Sintético (SCM), pero… ¿qué hacemos cuando no hay otros mercados con los que comparar y la empresa no es lo suficientemente grande como para construir un grupo de control sintético creíble?
Quiero presentarte ITSA (Interrupted Time Series Analysis, o análisis de series temporales interrumpidas), un método que llevo utilizando los últimos cuatro años en situaciones en las que no podemos ejecutar un experimento aleatorizado y las opciones, dentro del amplio universo de los estudios observacionales, son limitadas.
También te contaré cómo hemos creado un sistema multiagente para ejecutar estos análisis: las decisiones de arquitectura, estadística y software que hemos tenido que tomar, las renuncias que han implicado y las ventajas que ofrece este producto de datos.
ITSA y por qué merece la pena
Una breve introducción
Durante años, en negocio digital hemos resuelto estas situaciones comparando el periodo anterior y posterior a un cambio. Seguro que has escuchado algo parecido a «compara lo que ha pasado después del cambio con lo que pasaba antes». Quizá incluso te haya parecido una buena aproximación. Con todo el respeto: vamos a ver por qué se queda corta.
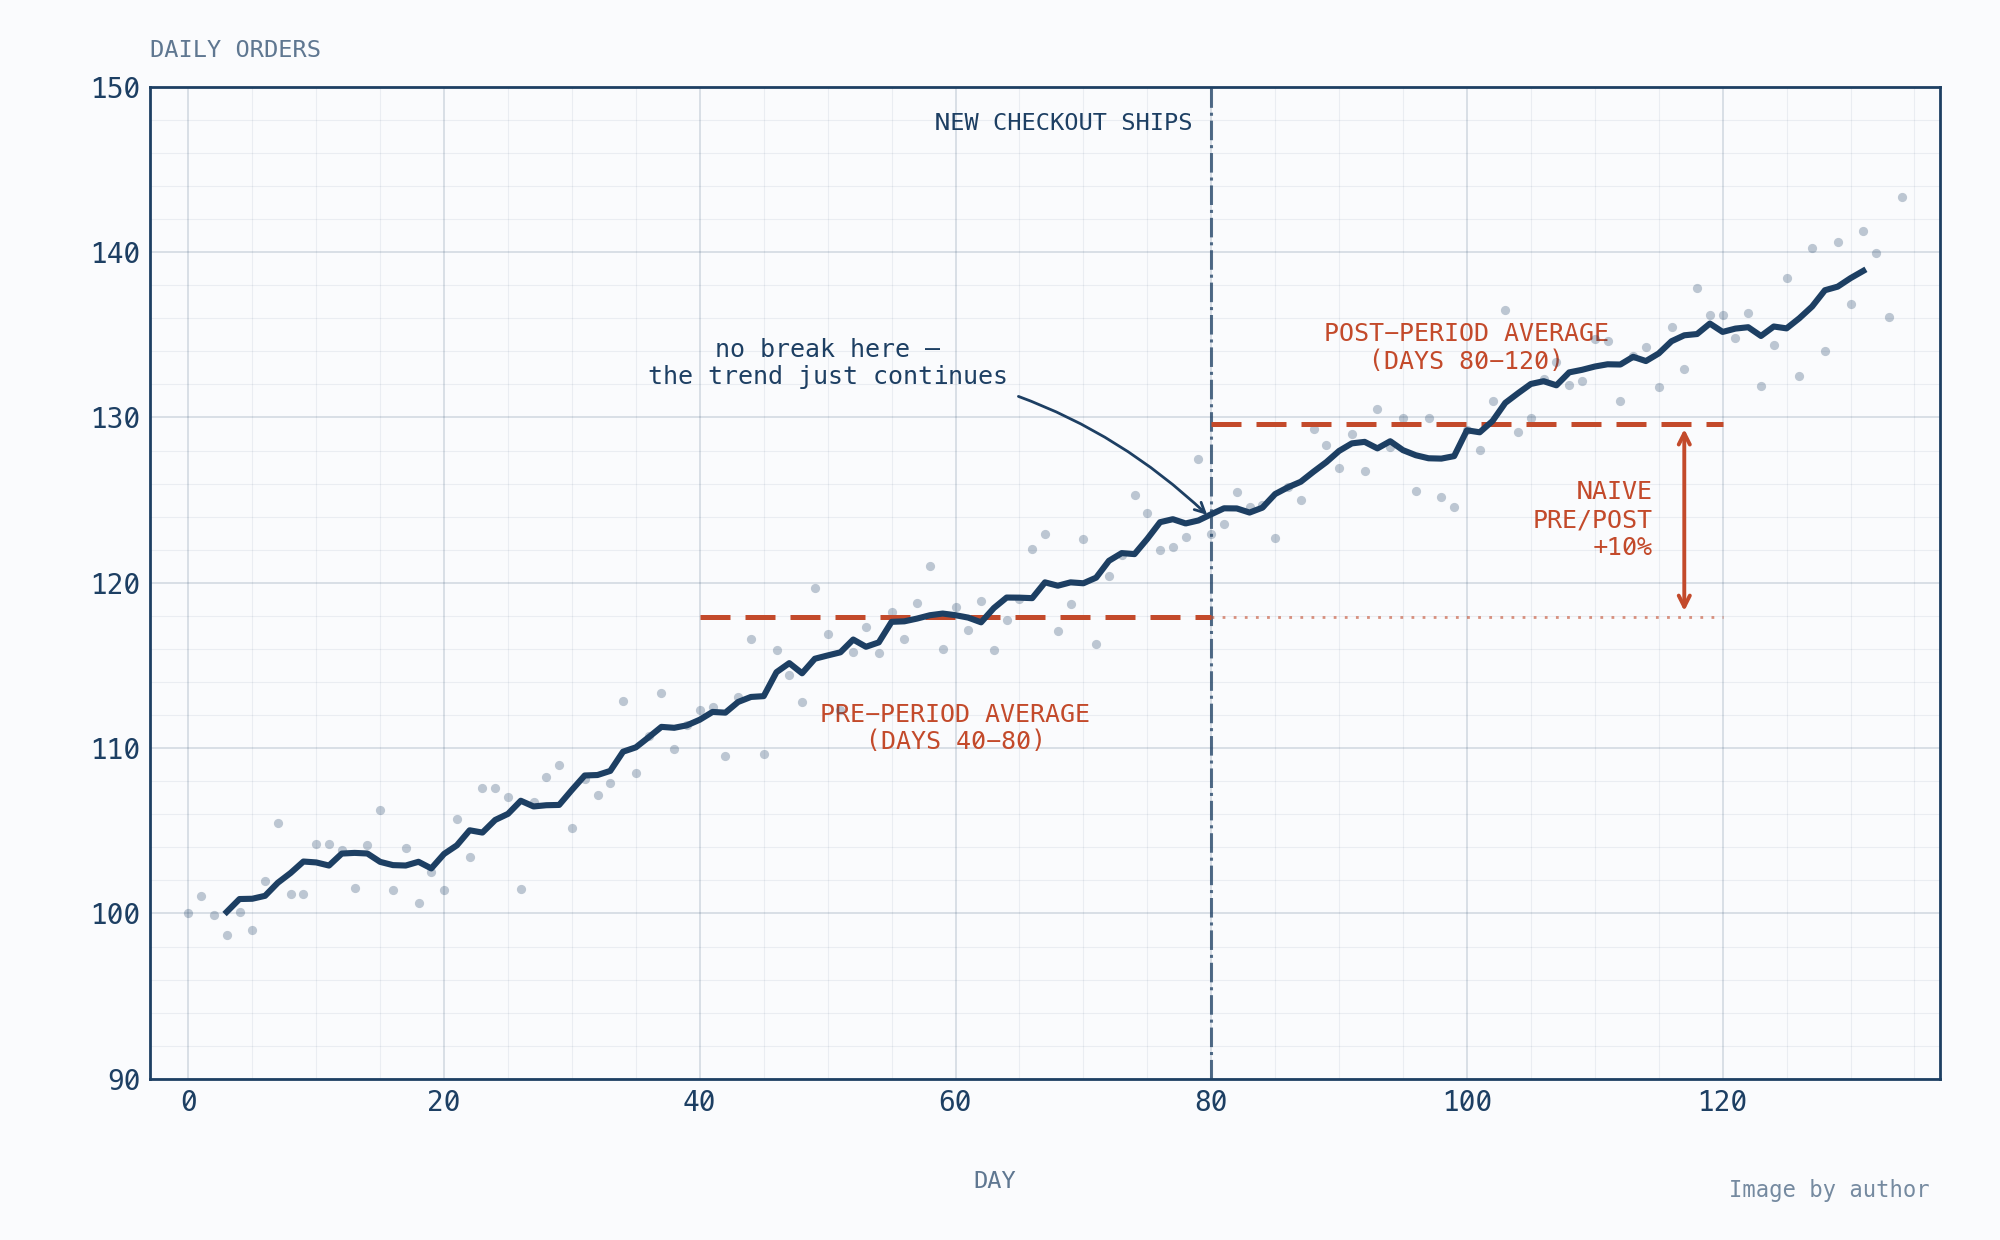
Desde una perspectiva estadística, comparar la media antes y después de la intervención es una aproximación ingenua: ignora las tendencias previas y la estacionalidad, no tiene en cuenta la autocorrelación al cuantificar la incertidumbre y no permite distinguir el efecto de la intervención del de otros eventos que suceden al mismo tiempo. En el escenario de la figura 1, esta comparación te llevaría a concluir que la intervención ha aumentado los pedidos diarios un 10%. Y te estarías equivocando.
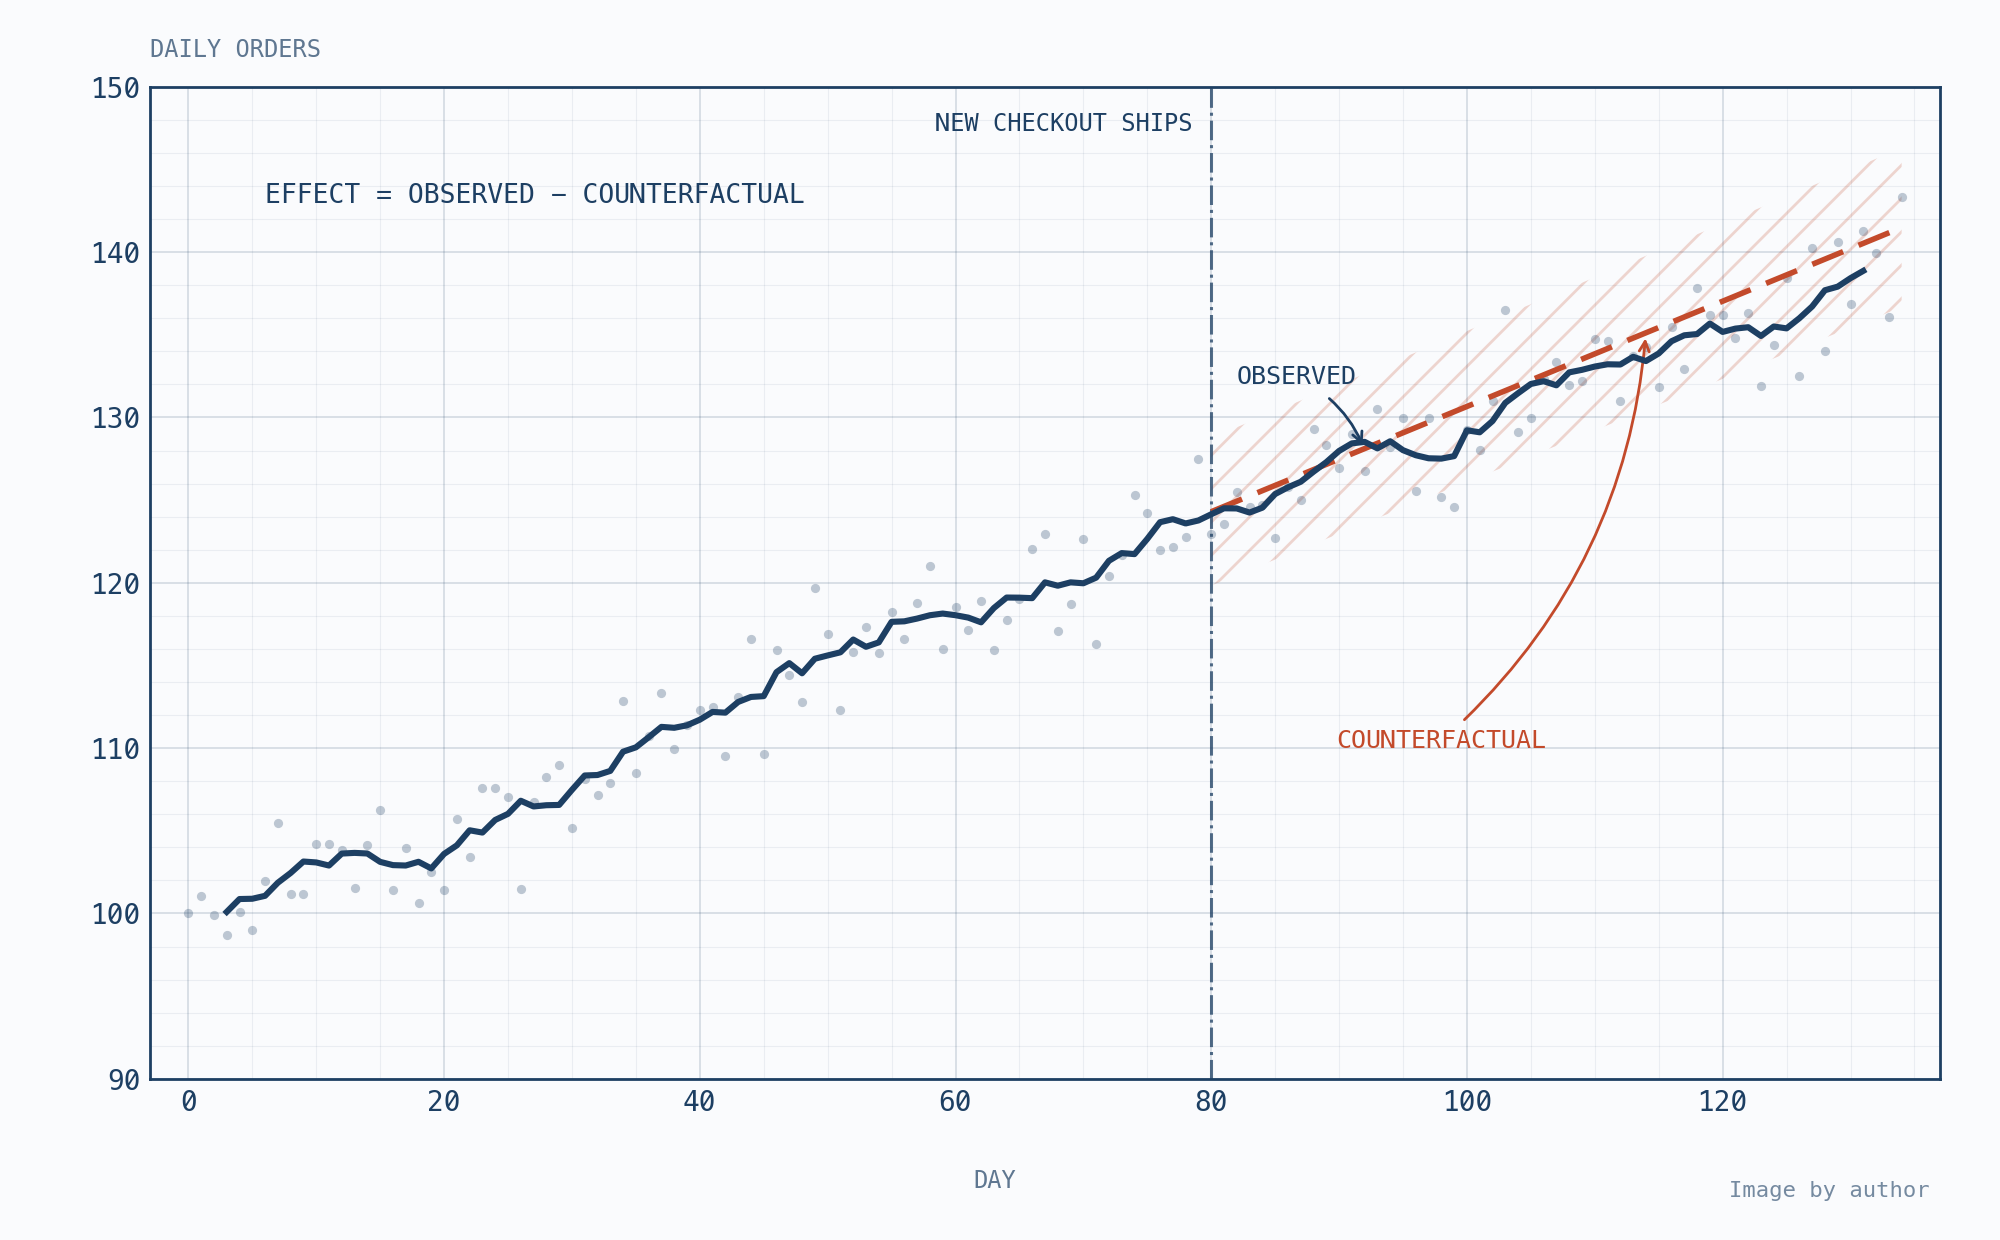
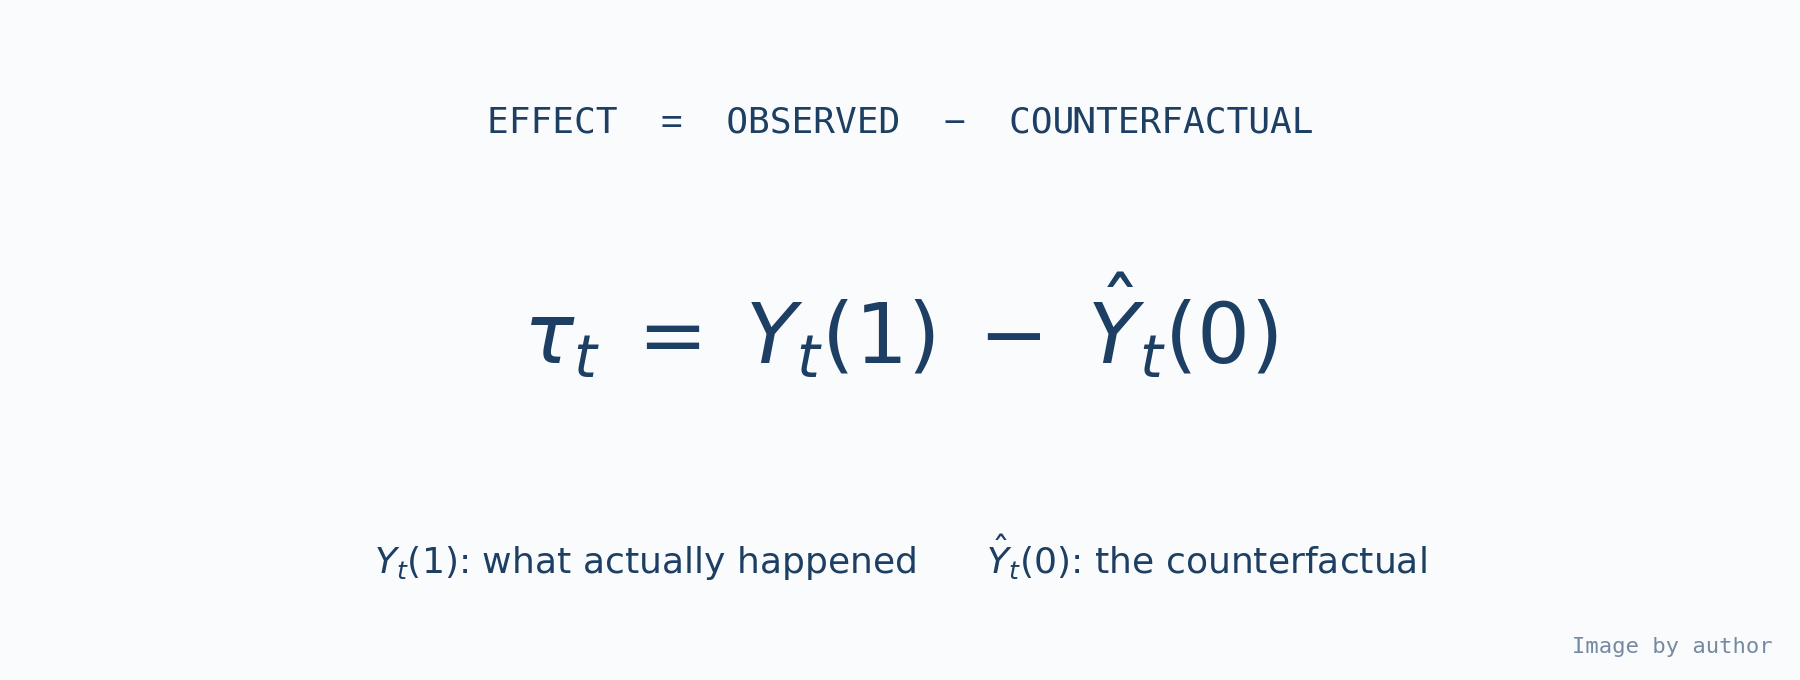
En la figura 2 vemos otra manera de abordar el problema. En lugar de comparar la media de los periodos previo y posterior, comparamos lo que ha pasado después de la intervención (observado) con lo que habría pasado si no hubiéramos lanzado el checkout de tres pasos (contrafactual). En este caso no hay un efecto positivo ni negativo atribuible a nuestra intervención. ¿Por qué? Porque el efecto se mide restando el contrafactual al valor observado.
¿Cómo estimamos ese contrafactual? Ahí está la cuestión: depende de la estrategia de identificación y de la técnica de estimación que utilicemos. Podemos usar Diferencia en diferencias si podemos asumir tendencias paralelas, Control Sintético si podemos construir un grupo de control sintético con una ponderación adecuada, etc.
ITSA utiliza la propia trayectoria de la métrica objetivo antes de la intervención para estimar qué habría pasado después si no hubiéramos intervenido. En su versión más sencilla, una regresión segmentada estima el nivel inicial y la tendencia previa, y proyecta esa trayectoria sobre el periodo posterior.
El efecto de la intervención es la diferencia entre la trayectoria observada después del cambio y ese contrafactual proyectado. Comparar el periodo posterior con el anterior responde a otra pregunta.
Assumptions de ITSA
Como cualquier método, ITSA tiene sus propios supuestos. Conviene conocerlos antes de utilizarlo para tomar la mejor decisión posible. Estos son los diez más importantes:
Continuidad del contrafactual. Si no hubiéramos intervenido, la tendencia previa habría continuado sin cambios. En un diseño con un único grupo, extrapolar esa tendencia es construir el contrafactual. Este es el supuesto que soporta todo el peso del análisis y, en esencia, no se puede comprobar: nunca observamos el mundo sin la intervención. Conecta directamente con el problema fundamental de la inferencia causal.
Un momento de intervención claro y conocido. Necesitamos una fecha de inicio bien definida.
Ausencia de otras intervenciones o shocks coincidentes en T0. Es lo que se conoce como amenaza de historia. Linden advierte expresamente del problema de que se produzcan varios cambios de política alrededor de la intervención.
Ausencia de anticipación. La intervención no afecta al periodo previo.
Las variables de confusión que cambian con el tiempo deben evolucionar de forma gradual. Así podemos distinguirlas del salto brusco asociado a la intervención. Un cambio abrupto en una de estas variables puede hacerse pasar por un efecto del tratamiento.
Control de la estacionalidad y los ciclos. Día de la semana, mes, campañas recurrentes, etc.
Suficientes observaciones antes y después, separadas por intervalos regulares. Una regla práctica habitual es contar con al menos 8 puntos por segmento. Si no hay suficientes observaciones, el efecto mínimo detectable (MDE) puede quedar por encima del efecto real y no lo detectaremos.
Tratamiento de la autocorrelación. Los errores de una serie temporal están correlacionados en el tiempo. Ignorarlo genera errores estándar e intervalos de confianza mal calibrados.
Medición consistente de la métrica objetivo. Su definición y su recogida no cambian entre el periodo previo y el posterior a la intervención.
Cumplimiento de los supuestos del propio modelo de regresión.
En esencia, ITSA parte de que, sin la intervención:
El proceso que generaba los datos antes del cambio habría continuado en el periodo posterior.
Ningún evento simultáneo explica la interrupción observada.
La fecha de la intervención y el patrón de impacto esperado están correctamente especificados.
La medición de la métrica objetivo se mantiene estable.
La tendencia, la estacionalidad y la dependencia entre los residuos están bien modelizadas.
¿Cuándo utilizar ITSA, entonces? Cuando coinciden estas tres condiciones. Si se dan, puede ser la mejor herramienta disponible:
No has podido aleatorizar. El cambio se ha lanzado a todo el mundo a la vez: un nuevo checkout, una actualización de precios o una migración SEO. No hay un grupo de usuarios sin tratamiento con el que comparar, así que el test AB queda descartado (que es precisamente el escenario con el que hemos empezado).
No tienes un grupo de control creíble. No hay otro mercado, región o línea de producto que se comportara de manera similar y que no haya recibido el cambio. Esto descarta DiD y Control Sintético: ambos necesitan unidades de comparación y no las tenemos. ITSA permite trabajar con un único grupo porque construye el contrafactual a partir de su propio histórico.
Tienes una serie temporal limpia. Una métrica medida de forma consistente, a intervalos regulares y con suficientes observaciones antes y después de una intervención cuya fecha conoces.
Conviene entender ITSA como un diseño de investigación, más que como una única técnica de estimación. Disponer de una serie temporal y de una fecha de intervención no es motivo suficiente para utilizarlo. Si la fecha es ambigua, el periodo previo ya está contaminado, sucede otro evento relevante alrededor de T0 o la serie ofrece demasiado poco recorrido temporal, un modelo más sofisticado no va a salvar la estrategia de identificación.
¿Por qué crear un sistema multi-agente que ejecuta ITSA?
Empezamos a ejecutar análisis de series temporales interrumpidas en 2023. Vimos que esta técnica podía aportar información adicional sobre el efecto real de una intervención. En nuestro caso, trabajamos en optimizar la experiencia de usuario y las conversiones mediante experimentación online, y había una pregunta que escuchábamos a menudo: «Vale, el efecto en este test AB es este, pero ¿veré ese uplift cuando lance la nueva versión?».
Es una pregunta difícil. No puedes responderla con otro test AB y, como comentaba al principio, DiD, RDD o SCM tampoco son siempre viables. Había que buscar alternativas. Ahí apareció ITSA.
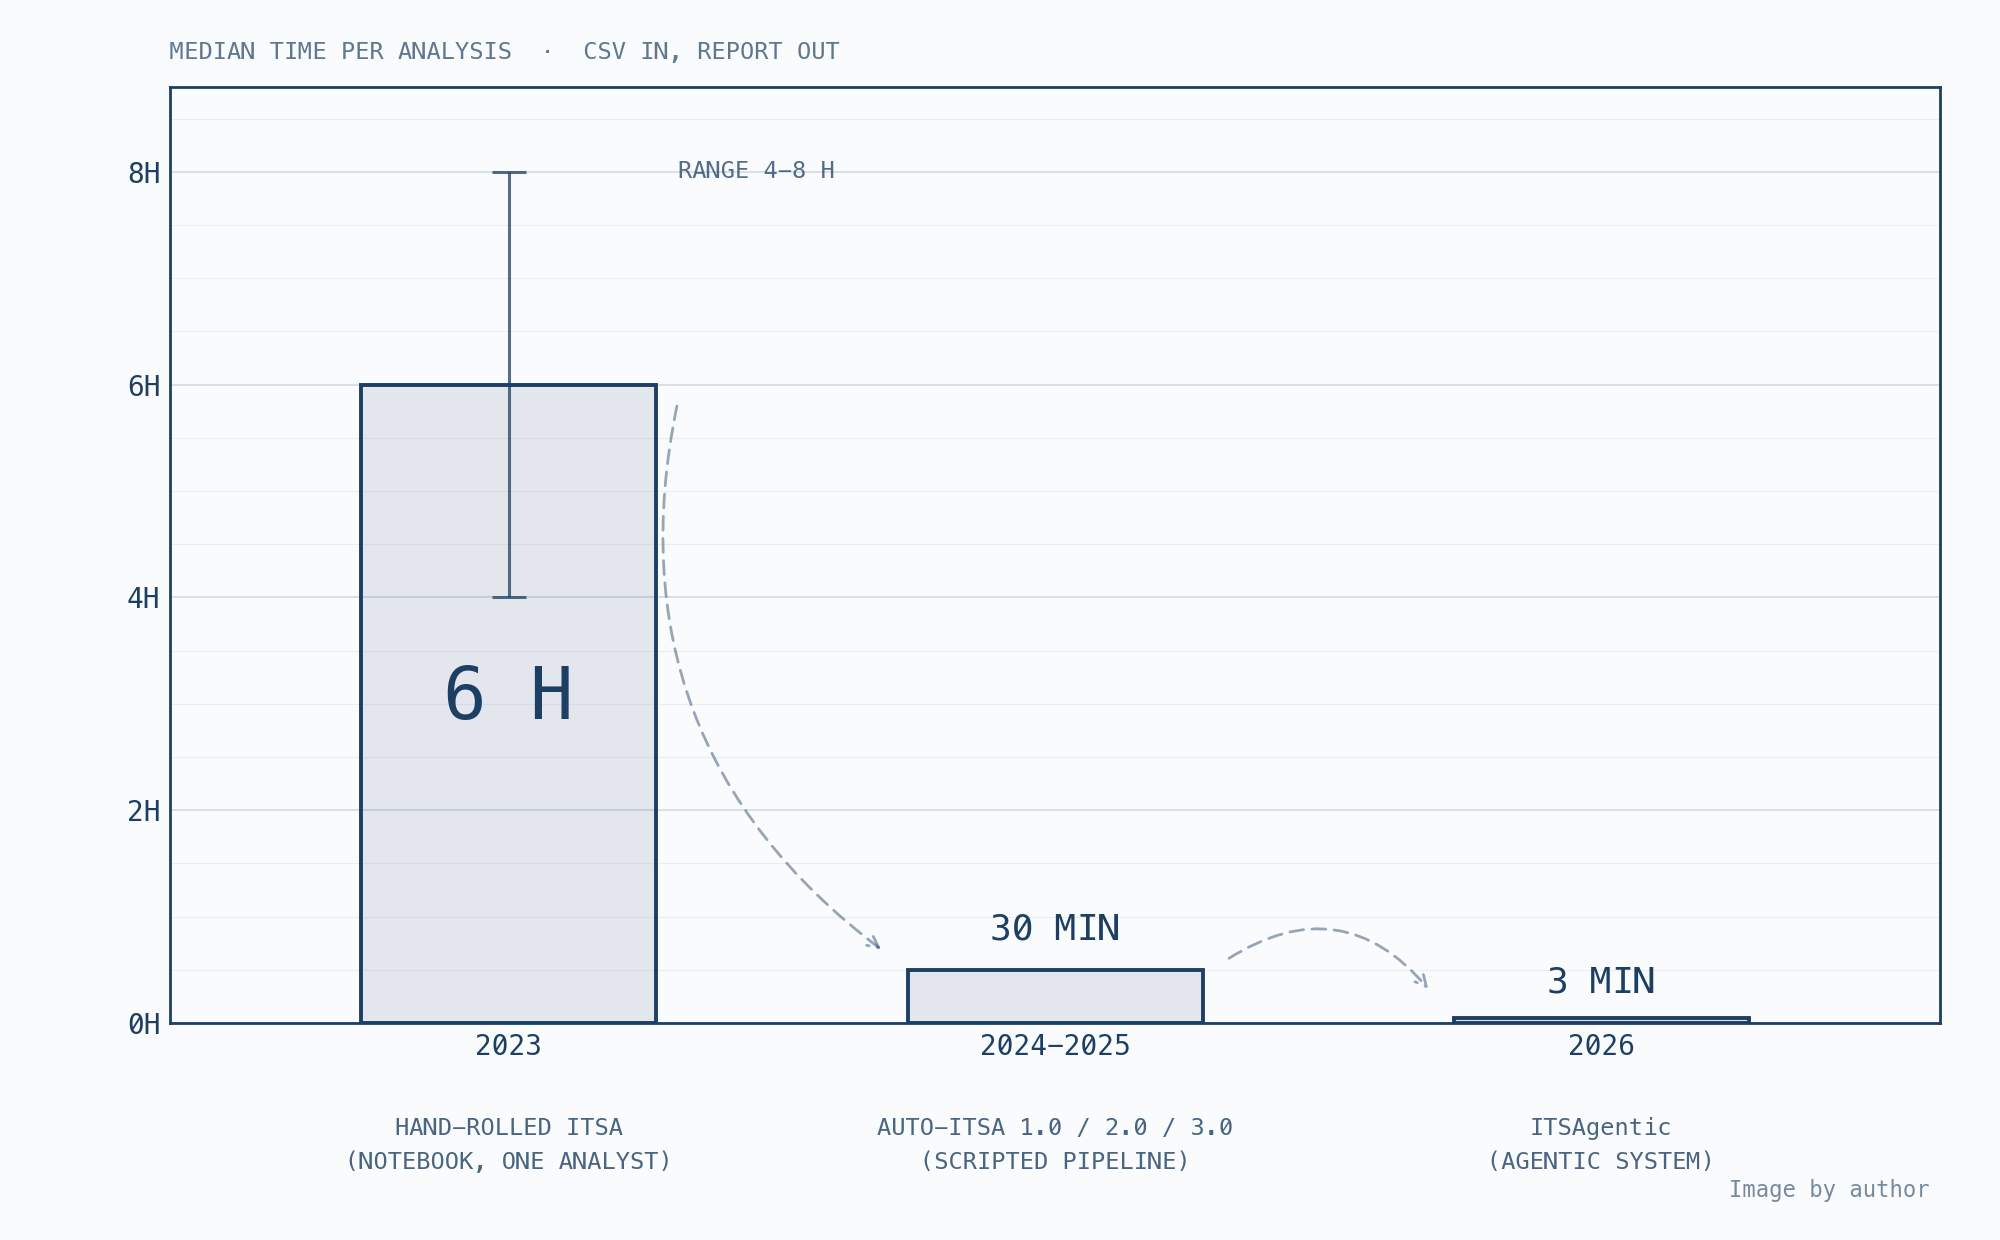
Como decía, empezamos en 2023 y dedicábamos unas 6 horas a cada análisis. Esta cifra es la mediana obtenida de los registros de tiempo del equipo de experimentación online. No era especialmente productivo, así que decidí crear un pipeline interno, al que llamamos Auto-ITSA, para análisis univariados y multivariados.
Auto-ITSA era, básicamente, una herramienta interna desarrollada en Python. Recibía los datos y, a partir de varios parámetros (fecha de intervención, tipo de dato, naturaleza del cambio…), determinaba automáticamente la aproximación estadística más adecuada: OLS, WLS, binomial negativa, etc. Todo ello para construir el mejor contrafactual posible. Con este pipeline mejoramos y estandarizamos el análisis ITSA y pasamos de 6 horas a 30 minutos por análisis.
Pero queríamos seguir mejorándolo: añadir más gráficas, más flexibilidad para distintos escenarios, nuevas librerías y aproximaciones… Ganábamos en capacidad técnica y estadística, pero perdíamos en time-to-value. Configurar Auto-ITSA 3.0 llevaba tiempo y cada nueva iteración exigía más conocimientos estadísticos.
Ese fue el día cero de ITSAgentic.
ITSAgentic como AI product
A principios de 2026 decidí crear ITSAgentic. Las capacidades de razonamiento de los LLM habían dado un salto importante en noviembre de 2025 y empecé con este esquema para concretar qué necesitaba construir.
ITSAgentic es un producto de IA que recibe un input (por ejemplo, un dataframe) junto con los parámetros que definen la intervención: la fecha, el tipo de métrica, la proporción de exposición y su forma (step, ramp, pulse o decay), entre otros. A partir de ahí, todo consiste en decidir qué análisis ejecutar y cómo interpretar sus resultados.
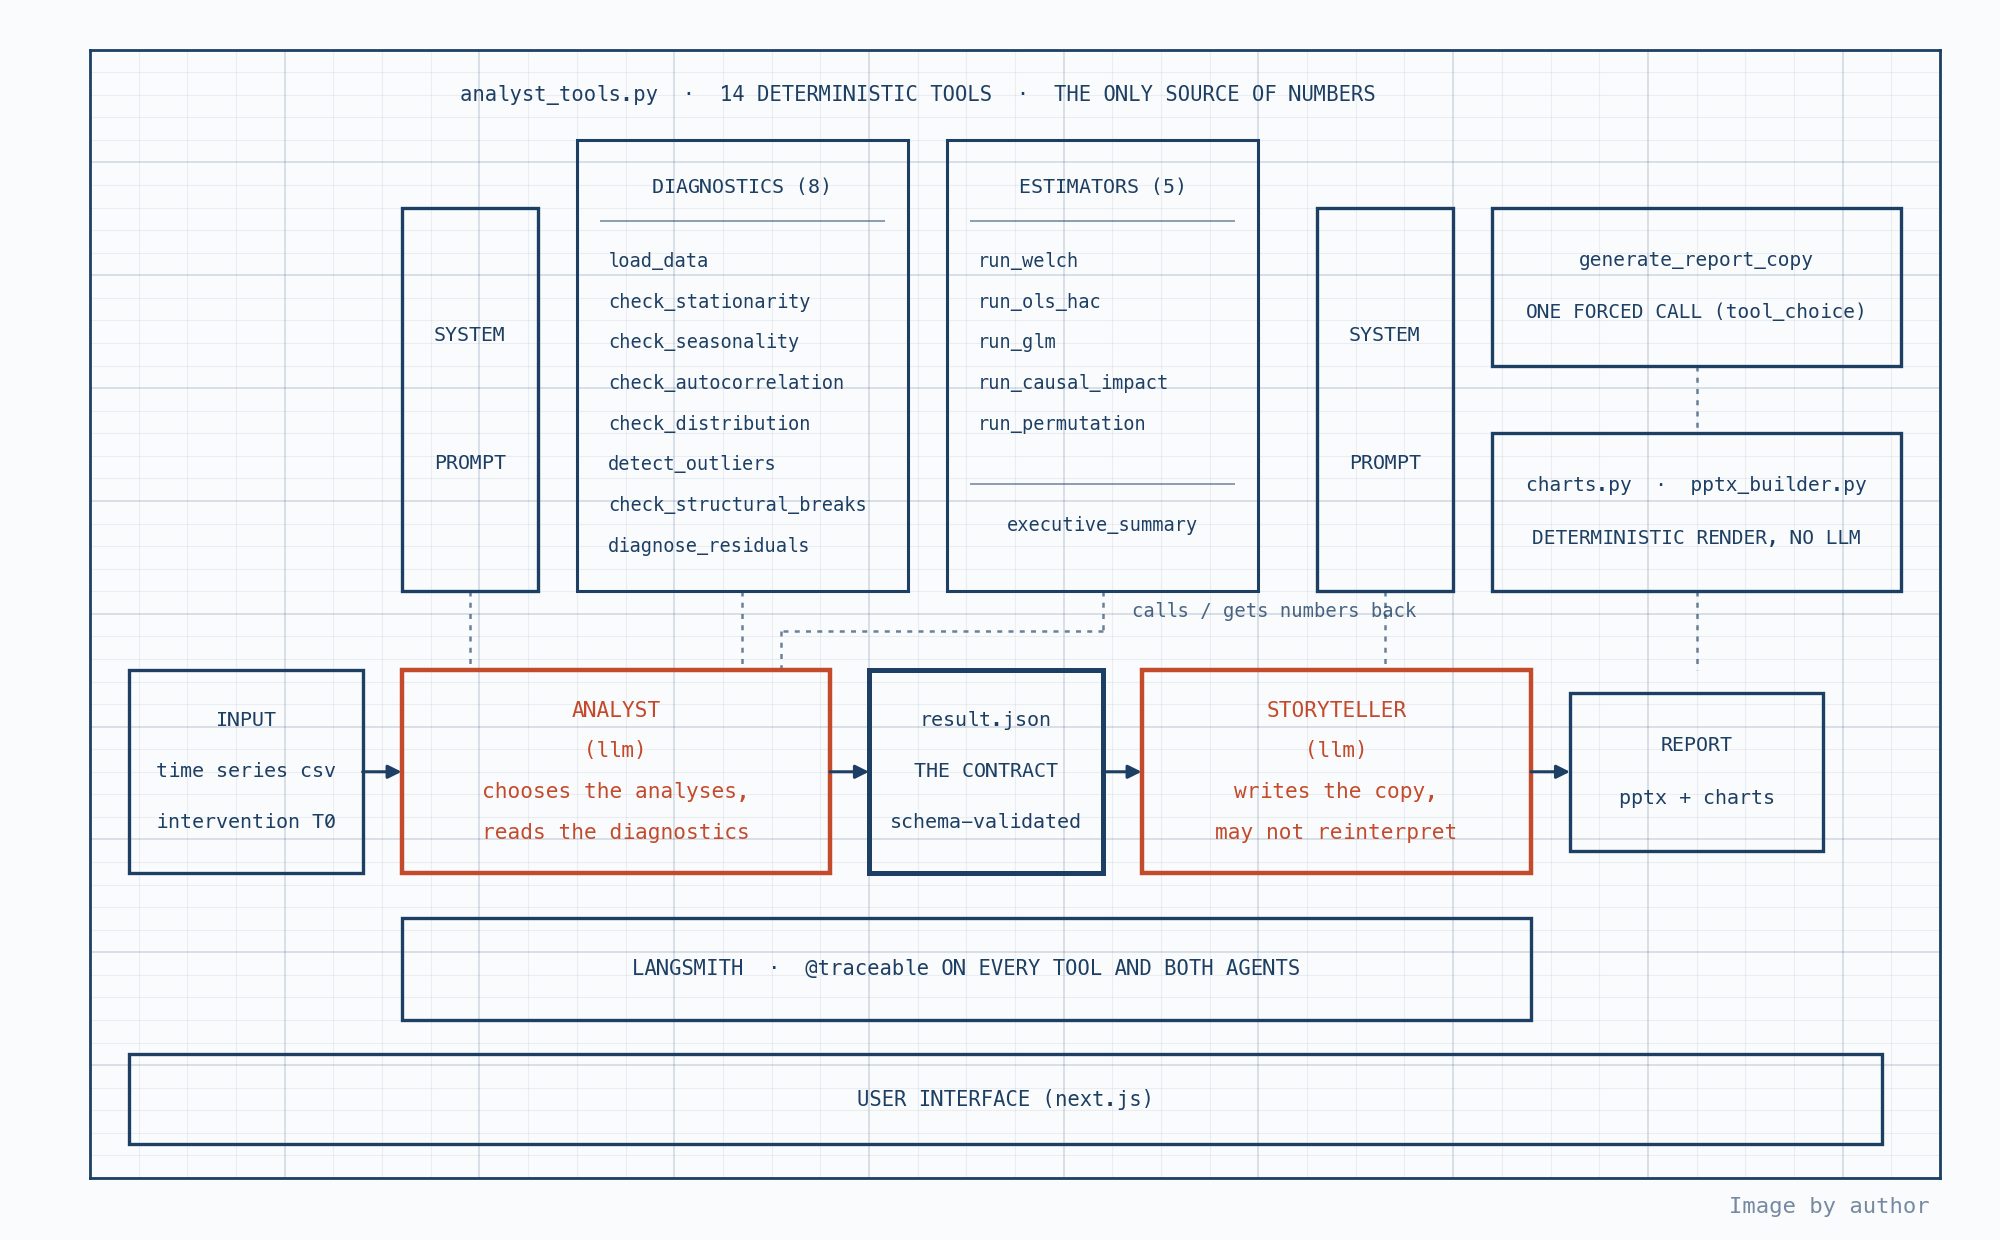
El primer agente es un analista cuantitativo. Sigue un orden predefinido (load_data, check_stationarity, check_seasonality, check_autocorrelation, etc.) y elige el estimador principal en función de los diagnósticos: OLS-HAC, GLM-NB, entre otros. Pero aquí hay una decisión de diseño fundamental: el modelo no calcula ni un solo número.
Las 14 herramientas están escritas en Python (statsmodels, scipy y pandas) y son deterministas por construcción: el mismo input devuelve siempre el mismo output, haya o no un LLM de por medio.
Lo que buscaba del modelo era que razonara sobre el resultado. Elegir el estimador adecuado para una serie de recuentos no estacionaria y con estacionalidad semanal requiere criterio. Calcular sus coeficientes es aritmética, y la aritmética es lo último que quieres dejar en manos de un LLM.
El analista termina con un executive_summary: el efecto y su incertidumbre, las advertencias que correspondan, un nivel de confianza y una recomendación seleccionada de un vocabulario cerrado. Por ejemplo: un uplift que no es estadísticamente significativo, ampliar el despliegue a más mercados o detener la intervención porque ha caído la métrica principal. Ese resumen se guarda en result.json, un archivo JSON validado contra un esquema. Es el único contenido que pasa de un agente al otro.
El segundo agente de ITSAgentic es el storyteller. Su trabajo consiste en convertir el resultado estadístico en una explicación que un stakeholder pueda leer. Separarlo del analista fue una decisión deliberada. Tiene su propia identidad (es quien presenta el análisis al negocio), su propio prompt base y sus propias herramientas, dedicadas a generar gráficas y construir diapositivas. El resultado es una presentación terminada. Prácticamente no comparten herramientas ni tono, así que los separé.
Hay un segundo motivo, que para mí es el más importante: el storyteller no puede inventarse nada. No ve el dataframe, no recibe la salida en bruto de las herramientas y no ejecuta ningún modelo. Recibe result.json y realiza una única llamada forzada para convertirlo en el texto que leerán los stakeholders.
No puede recalcular un efecto, convertir un «efecto no significativo» en una victoria ni eliminar discretamente una advertencia porque estropee la historia. Ninguno de esos números está a su alcance. Todo lo que diga debe partir de lo que el analista ya ha dejado por escrito.
La importancia de exposure share
En un ITSA de manual, la intervención se codifica con una variable binaria 0/1: antes de T0 está desactivada y, a partir de T0, se activa por completo y de golpe. Los cambios reales en un negocio digital rara vez funcionan así. Un nuevo checkout llega primero al 20% del tráfico y tarda dos semanas en alcanzar al resto. Una app se lanza mercado a mercado durante un mes y medio. Una campaña tiene mucha intensidad durante cinco días y después se detiene. La variable binaria da por hecho algo que no ha sucedido. Y todos los coeficientes que estimemos a partir de ahí arrastrarán esa ficción.
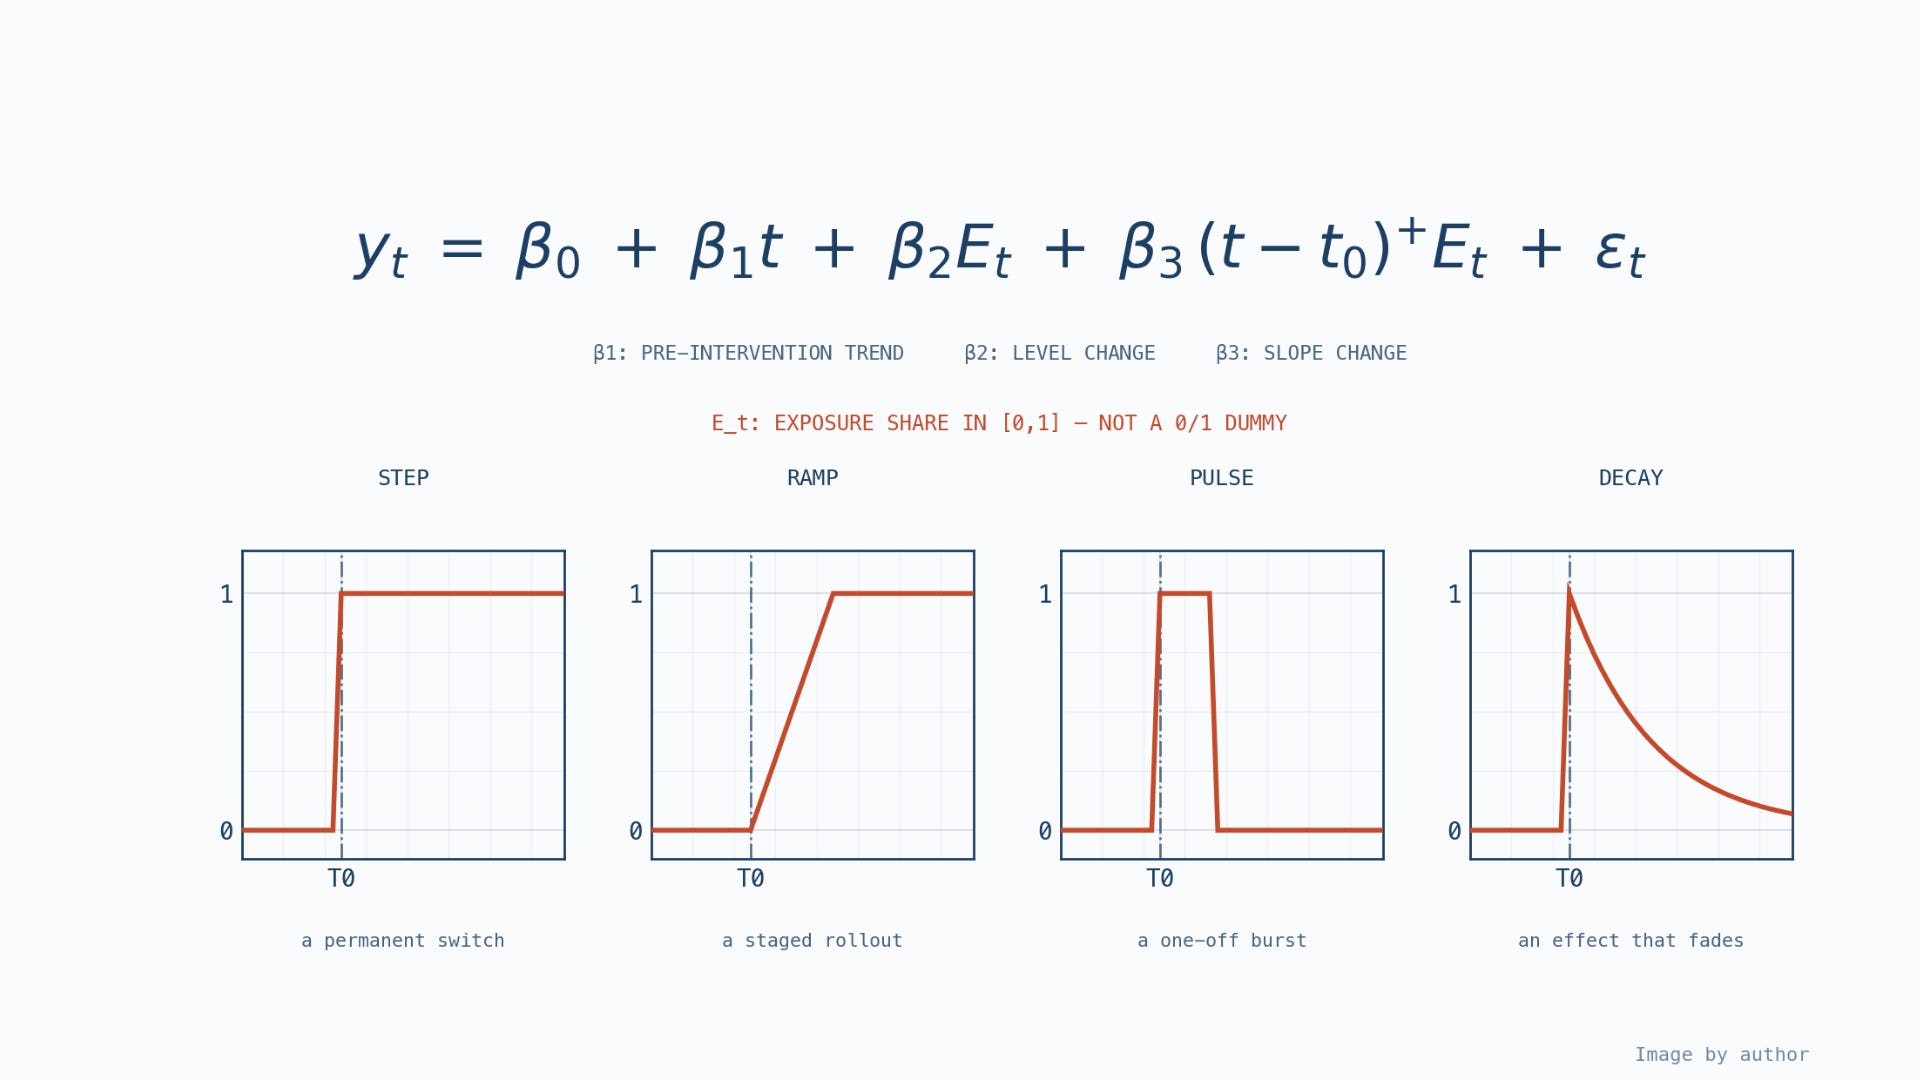
Por eso introducimos la intervención en la regresión mediante una proporción de exposición (exposure share), Et, con valores entre 0 y 1. Técnicamente, es un vector construido a partir de la fecha de intervención y de la forma que declaramos:
Step. El indicador clásico: vale 1 a partir de T0.
Ramp. Aumenta linealmente de 0 a 1 durante la ventana de despliegue y se mantiene en 1 a partir de entonces.
Pulse. Vale 1 mientras dura la acción y 0 antes y después.
Decay. Sigue la función exp(−(t−t₀)/τ), donde τ se deriva del tiempo que especifiques para que el efecto se reduzca a la mitad.
Ese vector entra dos veces en la matriz de diseño: una por sí solo y otra multiplicando el término de pendiente posterior a la intervención. Así, la contribución de la intervención en un día concreto es:
Eₜ · [β₂ + β₃(t − t₀)]
Los coeficientes pasan a interpretarse como cambios de nivel y de pendiente por unidad de exposición.
¿Qué ganamos con esto? Una precisión que ya estaba a nuestro alcance. Pensemos en el despliegue gradual por mercados: si lo codificamos como un escalón desde la primera fecha de lanzamiento, le estamos diciendo al modelo que toda la audiencia recibió el tratamiento desde el primer día, cuando la mayoría todavía no lo había recibido.
En esos primeros días posteriores al lanzamiento predominan los usuarios sin tratamiento, lo que empuja la estimación hacia cero. Un efecto real acaba diluido en un «no hay un cambio significativo».
La salida habitual consiste en mover T0 al día en que terminó el despliegue y descartar las semanas intermedias. A cambio de evitar ese sesgo, perdemos la mitad de los datos posteriores a la intervención. Con una proporción de exposición podemos incorporar cada día al modelo teniendo en cuenta qué parte de la audiencia había recibido realmente el cambio.
Y hay una cuestión de fondo: esa intensidad del tratamiento ya la conoces. Sabes qué porcentaje de tráfico has asignado, conoces el calendario de lanzamiento y sabes cuándo apagaste la campaña. Esa información está en un ticket o en una hoja de cálculo, pero una comparación convencional antes/después la descarta. Codificarla en Et no exige recoger más datos. Basta con aprovechar los que ya tienes.
Eso sí, aquí añadimos un supuesto: el modelo trata el efecto como lineal respecto a la exposición. Si llegamos al 40% de la audiencia, asumimos que se produce el 40% del efecto. Si los primeros usuarios expuestos responden de forma distinta a los últimos (por ejemplo, por un efecto novedad), Et estará mezclando intensidad y composición. El coeficiente no podrá distinguirlas.
Incorporar los diagnósticos de las assumptions
Los supuestos deben cumplirse antes y durante el análisis. Ahora bien, ¿cómo conseguimos que el agente compruebe los que hemos enumerado al principio? Si estás pensando en resolverlo con prompt engineering, este apartado te interesa.
La mayoría de las veces, el agente ignorará los supuestos. Un prompt se parece bastante a una lista de deseos, cuando lo que necesitamos es una lista de comprobaciones. Por eso ITSAgentic calcula las características del problema de forma determinista, en Python, antes de que el agente empiece a razonar.
Estas son trazas reales del caso con el que abríamos el artículo:
> load_data
status                ok
date_range            2024-03-01 → 2026-03-01
observations          731 (694 pre, 37 post)
raw_diff_pct          +15.29%

pre_trend_rsq         0.2209
pre_trend_slope_pval  <0.001
pre_end_excursion_z   0.98
pre_both_halves_sig   true
Fíjate en dos cosas de este output. La serie es distinta a la de la figura 1, pero raw_diff_pct: 15.29 es el mismo tipo de cifra: la comparación ingenua antes/después. Esa que se anuncia en una reunión como «hemos crecido un 15% desde el lanzamiento».
Aquí es un campo determinista más, calculado y registrado antes de que nadie se emocione. Justo debajo aparecen tres valores que describen el periodo previo a la intervención:
pre_trend_rsq: ¿la serie ya tenía tendencia antes de la intervención?
pre_end_excursion_z: ¿lo que pasó justo antes del cambio entra dentro de lo normal?
pre_both_halves_sig: ¿la tendencia se mantiene a lo largo de todo el periodo previo o depende de un tramo concreto?
Fíjate en el valor que devuelve: pre_trend_rsq: 0.22. Hay una tendencia previa (pre_trend_slope_pval: 0.001), pero solo explica una quinta parte de la varianza. Este es el tipo de cuestiones que conviene medir y no decidir a ojo. Dos pasos después, esa cifra determinará cuánto peso podemos dar al contrafactual extrapolado.
> check_stationarity
ADF   p = 0.1576    non-stationary
KPSS  p = 0.1000    stationary

Conflict detected:
ADF and KPSS disagree → possible weak unit root

Routing decision:   NON-STATIONARY
Después ejecutamos los tests habituales y resulta que no coinciden. ADF no rechaza la presencia de una raíz unitaria (p-valor = 0,16), mientras que KPSS no rechaza la estacionariedad. Considerados conjuntamente, los resultados son inconcluyentes.
En lugar de pedir al LLM que resuelva esa ambigüedad, la herramienta aplica una regla fija y conservadora: trata la serie como no estacionaria a la hora de seleccionar el modelo y deja registrados ambos resultados y su discrepancia. La decisión de qué camino seguir es reproducible, aunque la evidencia estadística siga siendo ambigua.
> check_autocorrelation
Durbin–Watson       1.296
Ljung–Box lag 1     p < 0.001
Ljung–Box lag 7     p < 0.001
Ljung–Box lag 14    p < 0.001
Ljung–Box lag 30    p < 0.001

Autocorrelation:    TRUE
Routing decision:   HAC standard errors
La autocorrelación tampoco se queda en una advertencia dentro de un prompt. Durbin-Watson en 1,30 y Ljung-Box significativo en todos los retardos: has_autocorrelation: TRUE. Ese único indicador obliga a utilizar errores estándar HAC en los pasos posteriores.
Cada uno de los tres indicadores anteriores está vinculado a uno de los supuestos del análisis:
pre_trend_rsq ayuda a vigilar el principal: la continuidad del contrafactual. En un diseño con un único grupo, el contrafactual se construye extrapolando la tendencia previa.
pre_end_excursion_z ayuda a vigilar la ausencia de anticipación. Un nivel anómalo justo antes de T0 indica que algo ya se había movido antes de nuestra intervención.
pre_both_halves_sig evita que confundamos la tendencia de un tramo con la tendencia de toda la serie. Comprueba si la pendiente se mantiene, en la misma dirección, en las dos mitades del periodo previo.
La idea de este apartado es sencilla: los diagnósticos vinculados a los supuestos del análisis se deben calcular, no delegar en una respuesta estocástica de un LLM. Usamos el LLM para razonar. Queremos que utilice las herramientas con libertad, pero que sus outputs sean siempre los mismos para evitar desviaciones importantes en las recomendaciones del agente.
¿Podemos confiar en ITSAgentic?
En marzo de 2026, Andrej Karpathy lanzó Autoresearch. Justo entonces estábamos buscando la mejor manera de mejorar ITSAgentic mediante evaluaciones con distintos datasets. Adaptamos ese ciclo al producto: modificar un componente, ejecutar de nuevo el benchmark completo, medir y conservar el cambio o revertirlo.
Utilizamos más de 150 datasets distintos, con casos reales, semisintéticos y sintéticos. Comparamos cada ejecución con un ground truth: para cada escenario, el efecto introducido, si se espera que pueda detectarse, su dirección y las advertencias que el agente debe señalar.
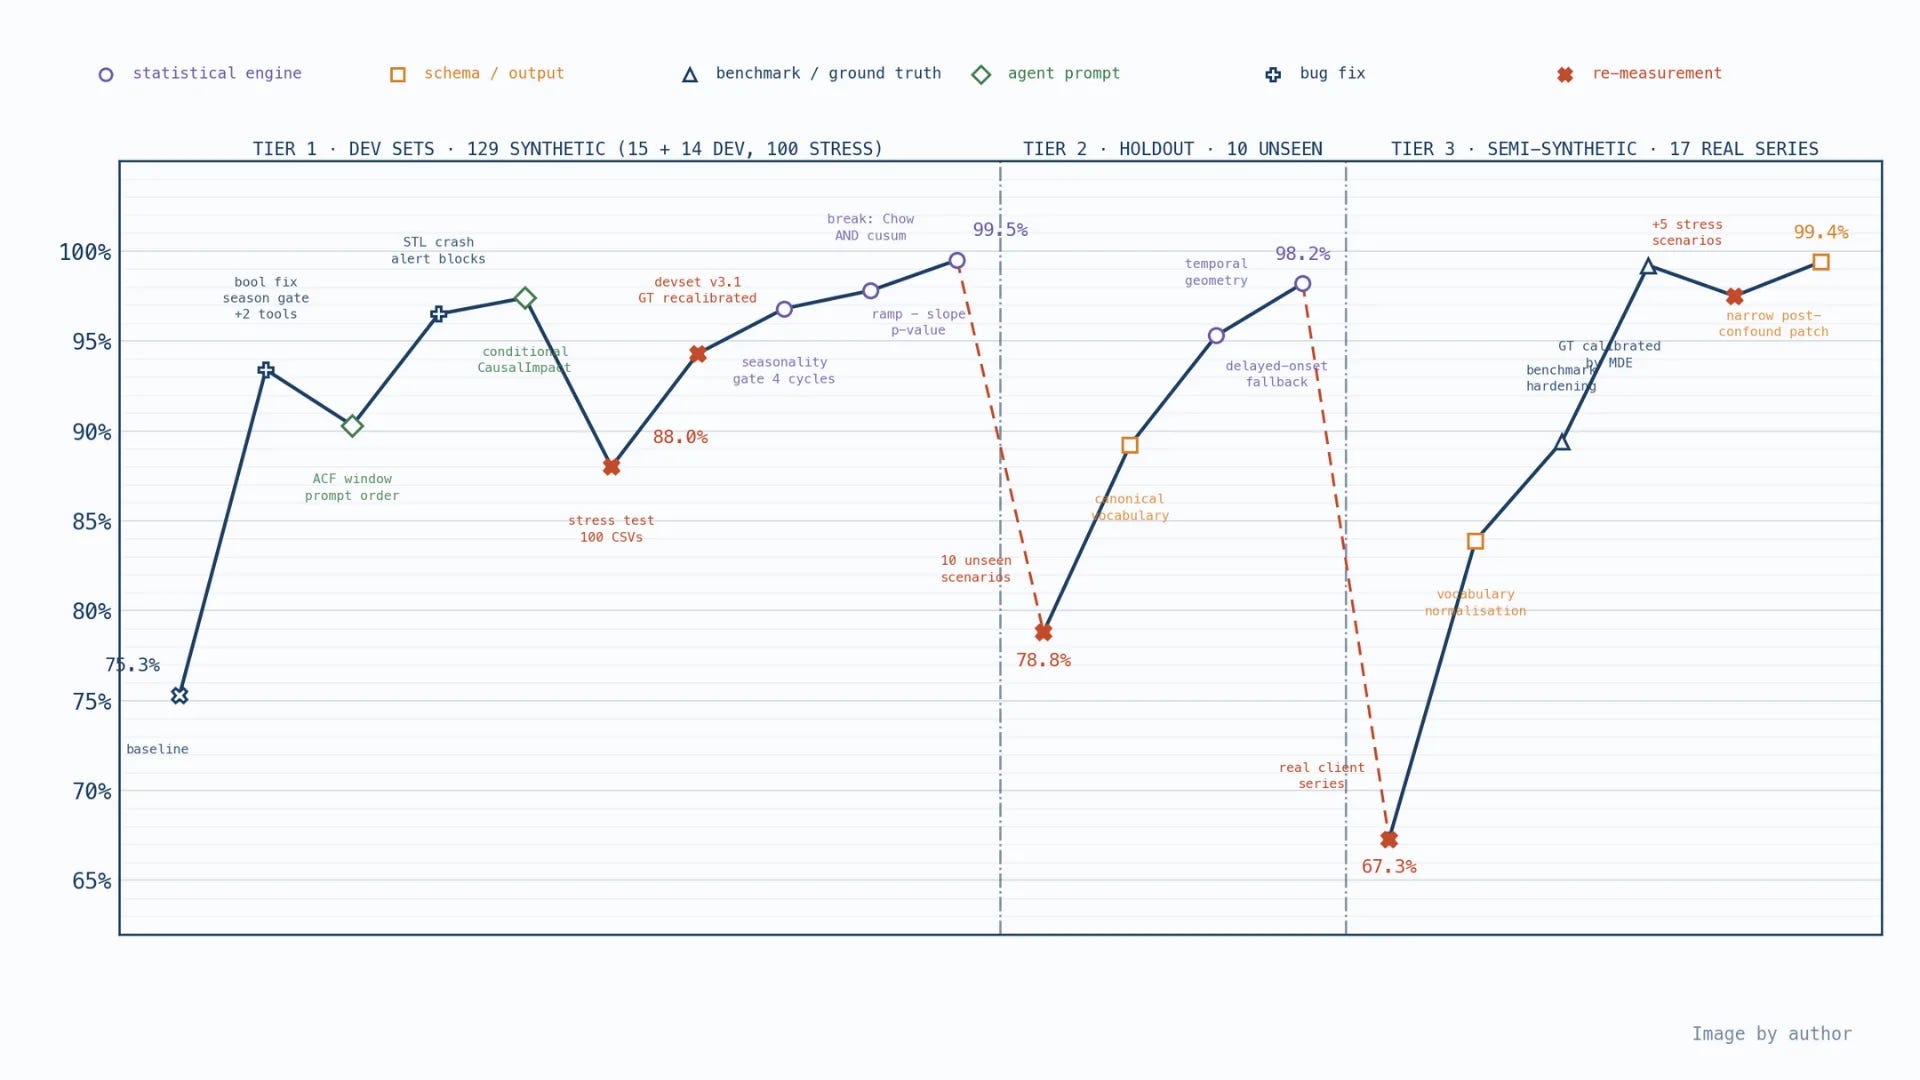
Cada punto de esa línea representa una iteración: cambiar algo, ejecutar el benchmark completo, medir y conservar o descartar el cambio. El color indica qué se ha modificado: el motor estadístico, el esquema del output, el prompt del agente, el propio benchmark o, sencillamente, un bug. La altura representa la puntuación combinada frente al ground truth.
Las tres franjas corresponden a tres sesiones distintas con datasets de diferente naturaleza. La gráfica es el propio registro de los experimentos. No la dibujé después para explicar el proceso.
Conviene detenerse en lo que significa esa puntuación, porque todo este apartado depende de ello. Cada ejecución se evalúa en dos capas: las comprobaciones deterministas aportan el 40% de la puntuación y un LLM que actúa como juez aporta el 60% restante.
La capa determinista contrasta el output con el ground truth: ¿ha detectado un efecto cuando se esperaba que pudiera detectarlo, sin afirmar que lo había detectado cuando no correspondía? ¿Ha acertado en la dirección? ¿La magnitud estimada está dentro de un margen de ±30% respecto al efecto real? ¿Ha clasificado correctamente la estacionariedad? ¿Ha evitado un test inadecuado? ¿Cuántas de las trampas introducidas en el escenario ha señalado como advertencias?
El LLM juez puntúa cinco dimensiones del texto generado: calidad del diagnóstico, selección del modelo, interpretación, honestidad al exponer las limitaciones y comunicación con negocio. Tiene más peso porque de ITSAgentic esperamos tanto un resultado correcto como un razonamiento y una explicación que sirvan para tomar una decisión de negocio.
Sé que las caídas de la gráfica llaman la atención, pero lo interesante es qué tipo de corrección explica cada recuperación. Tier 1 mejora con correcciones de bugs y trabajo estadístico: un booleano mal serializado, un criterio de estacionalidad, una regla sobre rupturas estructurales. Tier 2 mejora con las reglas de ajuste basadas en la geometría temporal.
Tier 3 es distinto: no hubo ni un cambio en el motor estadístico ni uno en el prompt. Las mejoras llegaron por dos tipos de trabajo semántico. La mayor parte consistió en normalizar el vocabulario del output para que lo que decía el agente coincidiera con lo que esperaba el evaluador. La respuesta era correcta, pero las palabras no encajaban.
Y en dos ocasiones el problema estaba en el propio examen. Un escenario exigía detectar un efecto del +5% que estaba por debajo del MDE de esa serie. Otro exigía un veredicto positivo sobre un efecto cuyo p-valor era 0,996 una vez extrapolada la tendencia previa.
En ambos casos, el agente devolvió detected: false con un nivel de confianza bajo. Esa era la inferencia correcta: si una serie no tiene potencia suficiente para detectar un efecto, no podemos reportarlo como detectado. Fíjate en la distinción, porque el propio ground truth tampoco la hacía. El +5% se había introducido de verdad. El error estaba en el examen, que puntuaba un efecto real como si, necesariamente, tuviera que ser detectable.
¿Cuál fue el verdadero aprendizaje? Las mejoras fueron apareciendo iteración tras iteración. Primero resolvimos problemas aritméticos, después estadísticos y, en el último tramo, todo era semántica. Cuando el sistema llegó a los datos reales, su núcleo estadístico ya no necesitó una línea más de código.
ITSAgentic: ¿cuándo sí, cuándo no y por qué?
Quiero ser honesto sobre el lugar que ocupa este método. ITSA es una herramienta fantástica y supone un paso real respecto a comparar medias, pero está lejos de ser la estrategia de identificación más sólida entre las opciones cuasiexperimentales.
En mi opinión, tiene dos problemas estructurales. El primero es que todo el diseño depende de que la tendencia previa tenga suficiente capacidad predictiva para actuar como contrafactual. Como muestran Morgan y Winship, cuando el contrafactual real se curva, la extrapolación lineal no falla de forma evidente: sobreestima silenciosamente el efecto en cada uno de los días posteriores a la intervención.
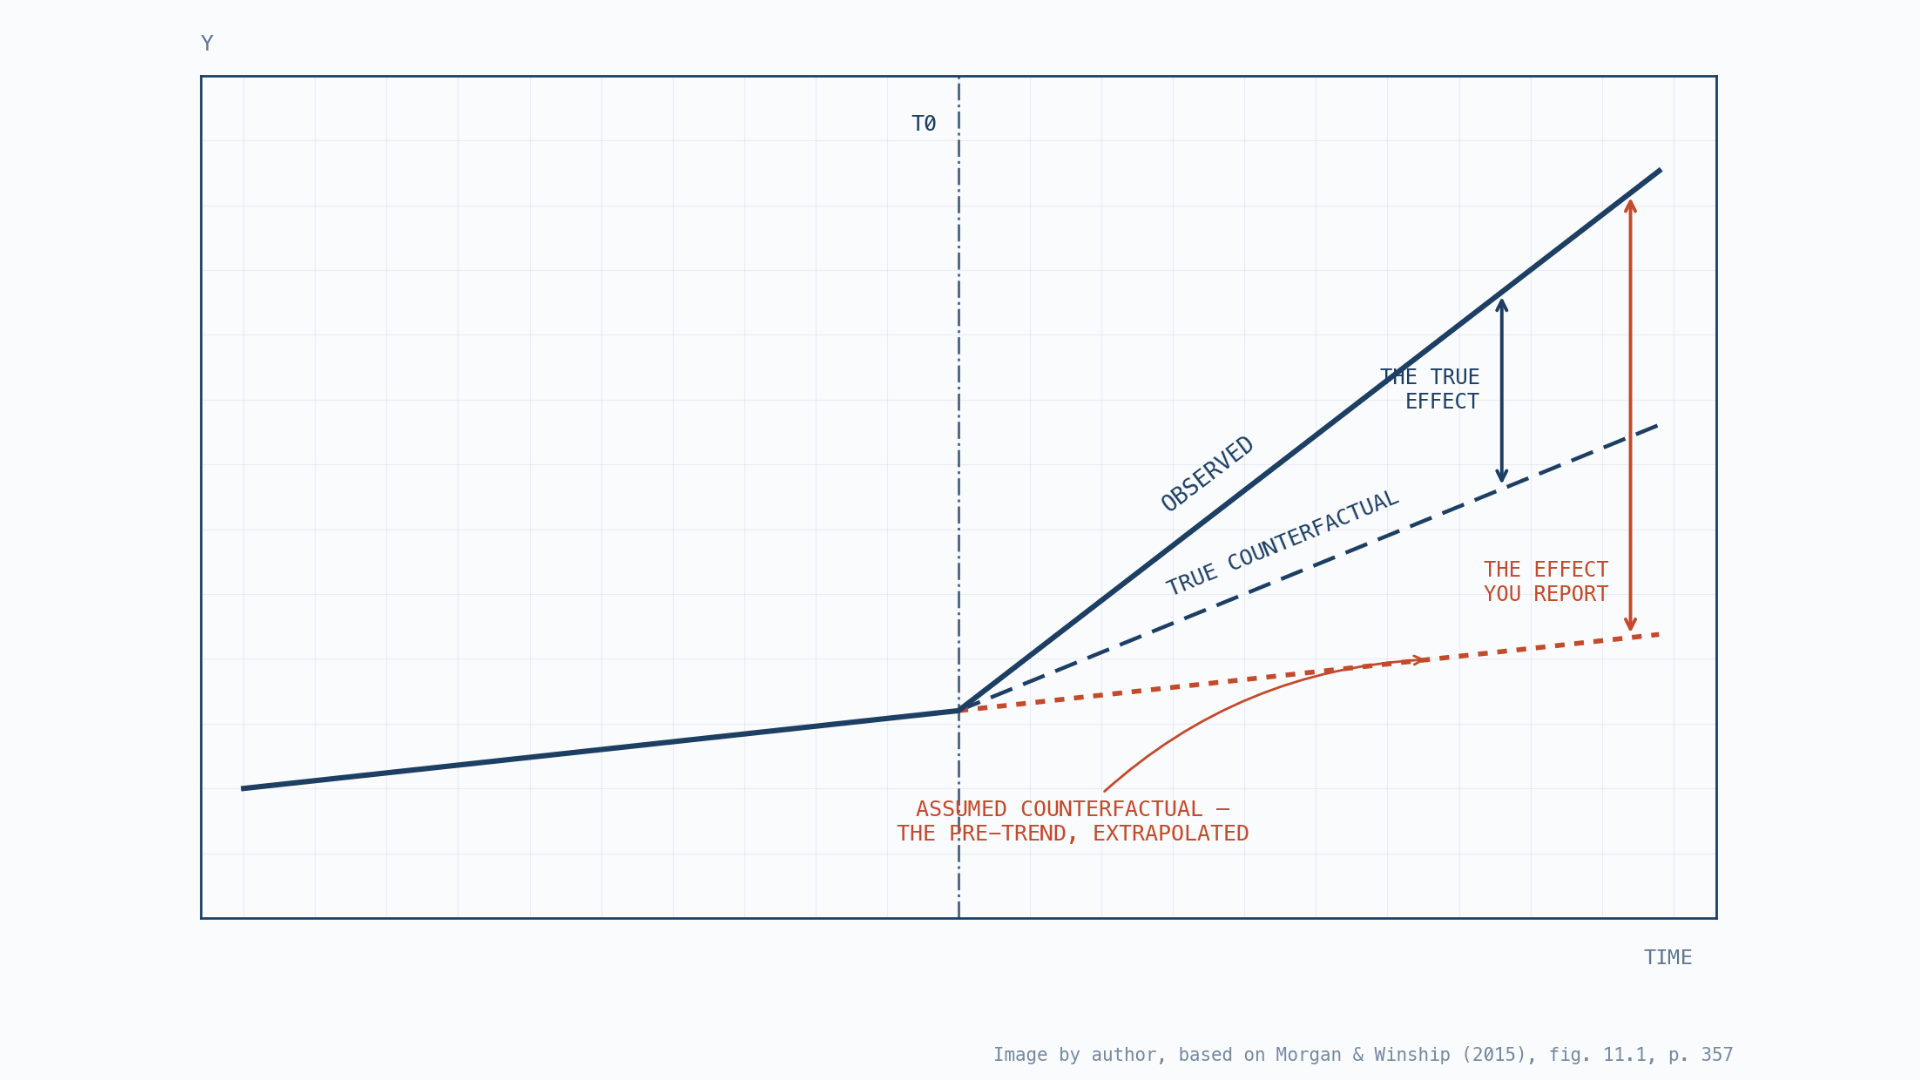
El segundo problema es la otra cara de la moneda: el diseño atribuye a la intervención cualquier desviación respecto a la trayectoria proyectada, la haya causado o no. Linden señala la raíz del problema: un ITSA con un único grupo no tiene grupo de control, así que la trayectoria previa proyectada debe asumir ese papel.
Las covariables permiten ajustar por variables de confusión observadas que cambian con el tiempo y mejorar la predicción contrafactual. Sin embargo, no permiten descartar shocks no observados que coincidan con la intervención. Por eso DiD o Control Sintético pueden ser opciones más defendibles cuando disponemos de una serie de comparación creíble.
Esos son los límites del método. ITSAgentic, además, tiene los suyos: hay una familia de comprobaciones que todavía no ejecuta. La primera es el placebo in time: repetir el análisis con una fecha de intervención ficticia dentro del periodo previo, cuando no sucedió nada. Si el pipeline detecta un efecto ahí, algo falla en el diseño. Esa prueba dice más sobre la confianza que merece un resultado que cualquiera de los diagnósticos de este artículo.
La segunda es el análisis de sensibilidad: ¿cuánto cambia la estimación si desplazamos T0 unos días o si la forma de exposición que hemos declarado es incorrecta? La forma se declara una sola vez, antes del análisis, y queda registrada. Es una protección mínima para evitar ajustar la geometría hasta conseguir un p-valor conveniente. Pero declarar un parámetro no equivale a saber cuánto depende de él la respuesta.
Y, aun así, este es precisamente el tipo de método que merece la pena convertir en un producto de IA. Durante años, el razonamiento contrafactual ha quedado prácticamente reservado a científicos de datos especializados. Ahora, una persona de marketing o producto puede subir un CSV, indicar una fecha de intervención y recibir un análisis con contrafactual, incertidumbre y advertencias. Hasta hace poco, eso exigía un especialista que la mayoría de las empresas no tiene.
Es un caballo de Troya. ITSA permite explicar los contrafactuales: una línea muestra lo que ha pasado, otra lo que habría pasado y la distancia entre ambas es el efecto. Un stakeholder sin perfil técnico lo entiende.
Cuando tu organización empieza a pensar en contrafactuales, has ganado credibilidad para introducir diseños más complejos y con una identificación causal más sólida. No podemos olvidar que detrás de todo lo que hacemos hay negocio, y que gestionar a los stakeholders forma parte del trabajo.
La IA generativa permite construir productos de datos como este de una manera que hace dos años no estaba a nuestro alcance. Eso sí: el output debe ser seguro y seguir unas reglas predefinidas. Necesitamos herramientas deterministas y parámetros cerrados que garanticen que el mismo input produce siempre los mismos números. El razonamiento del modelo debe dedicarse a donde aporta valor: decidir qué ejecutar e interpretar qué significa el resultado, asumiendo que puede ofrecer interpretaciones ligeramente distintas sobre unos mismos datos. Ese es el porqué de todo el artículo y del futuro de los AI products aplicados a data.
Fuentes:
Linden, A. (2015). Conducting interrupted time-series analysis for single- and multiple-group comparisons. The Stata Journal, 15(2), 480–500. — SAGE · PDF
Linden, A. (2017). Challenges to validity in single-group interrupted time series analysis. Journal of Evaluation in Clinical Practice, 23(2). — Wiley
Linden, A. (2016). Persistent threats to validity in single-group interrupted time series analysis with a crossover design. — PubMed
Morgan, S. L., & Winship, C. (2015). Counterfactuals and causal inference: Methods and principles for social research (2nd ed.). Cambridge University Press.
Karpathy, A. (2026). autoresearch — github.com/karpathy/autoresearch.
Brodersen, K. H., et al. (2015). Inferring causal impact using Bayesian structural time-series models. Annals of Applied Statistics, 9(1), 247–274.
Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2017). Interrupted time series regression for the evaluation of public health interventions: A tutorial. International Journal of Epidemiology, 46(1), 348–355.
Nota: este artículo se ha traducido del inglés al castellano con la ayuda de IA generativa. Puedes leer la versión original aquí y aquí en Towards Data Science.
¡Muchísimas gracias por el aporte, Ubaldo! Me viene en un momento muy útil: con la IA estoy lanzando pruebas y cambios cada dos por tres y, con esa facilidad para pasar de la idea a la ejecución, a veces se me olvida parar a pensar cómo voy a medir si han funcionado.
Simplemente lanzo, veo que los resultados mejoran o empeoran y luego no tengo claro cuánto puedo atribuir a los cambios realizados. Siempre me queda la pregunta: ¿qué habría pasado sin ese cambio?
Con ese runrún encontré un post de Pelayo sobre CausalImpact y he empezado a incorporarlo a mis análisis
Aprovechando que has sacado el tema :) ahora que he empezado a usar CausalImpact en mis análisis, al leerte me ha surgido una duda, desde mi conocimiento todavía limitado de esta parte estadística: ¿cómo se relaciona CausalImpact con el enfoque que utilizas? Entiendo que ambos permiten estimar qué habría pasado sin el cambio, pero no termino de entender en qué se diferencian ni si tiene sentido compararlos directamente.